Por Prompt Lab | Transmediatics
10 de octubre de 2026
La generación de imágenes con inteligencia artificial está entrando en una etapa en la que escribir un prompt ya no consiste simplemente en describir lo que queremos ver. Ahora, el desafío es conseguir que el modelo interprete nuestras instrucciones con mayor precisión, respete las referencias visuales y mantenga la coherencia entre los diferentes elementos de una composición.
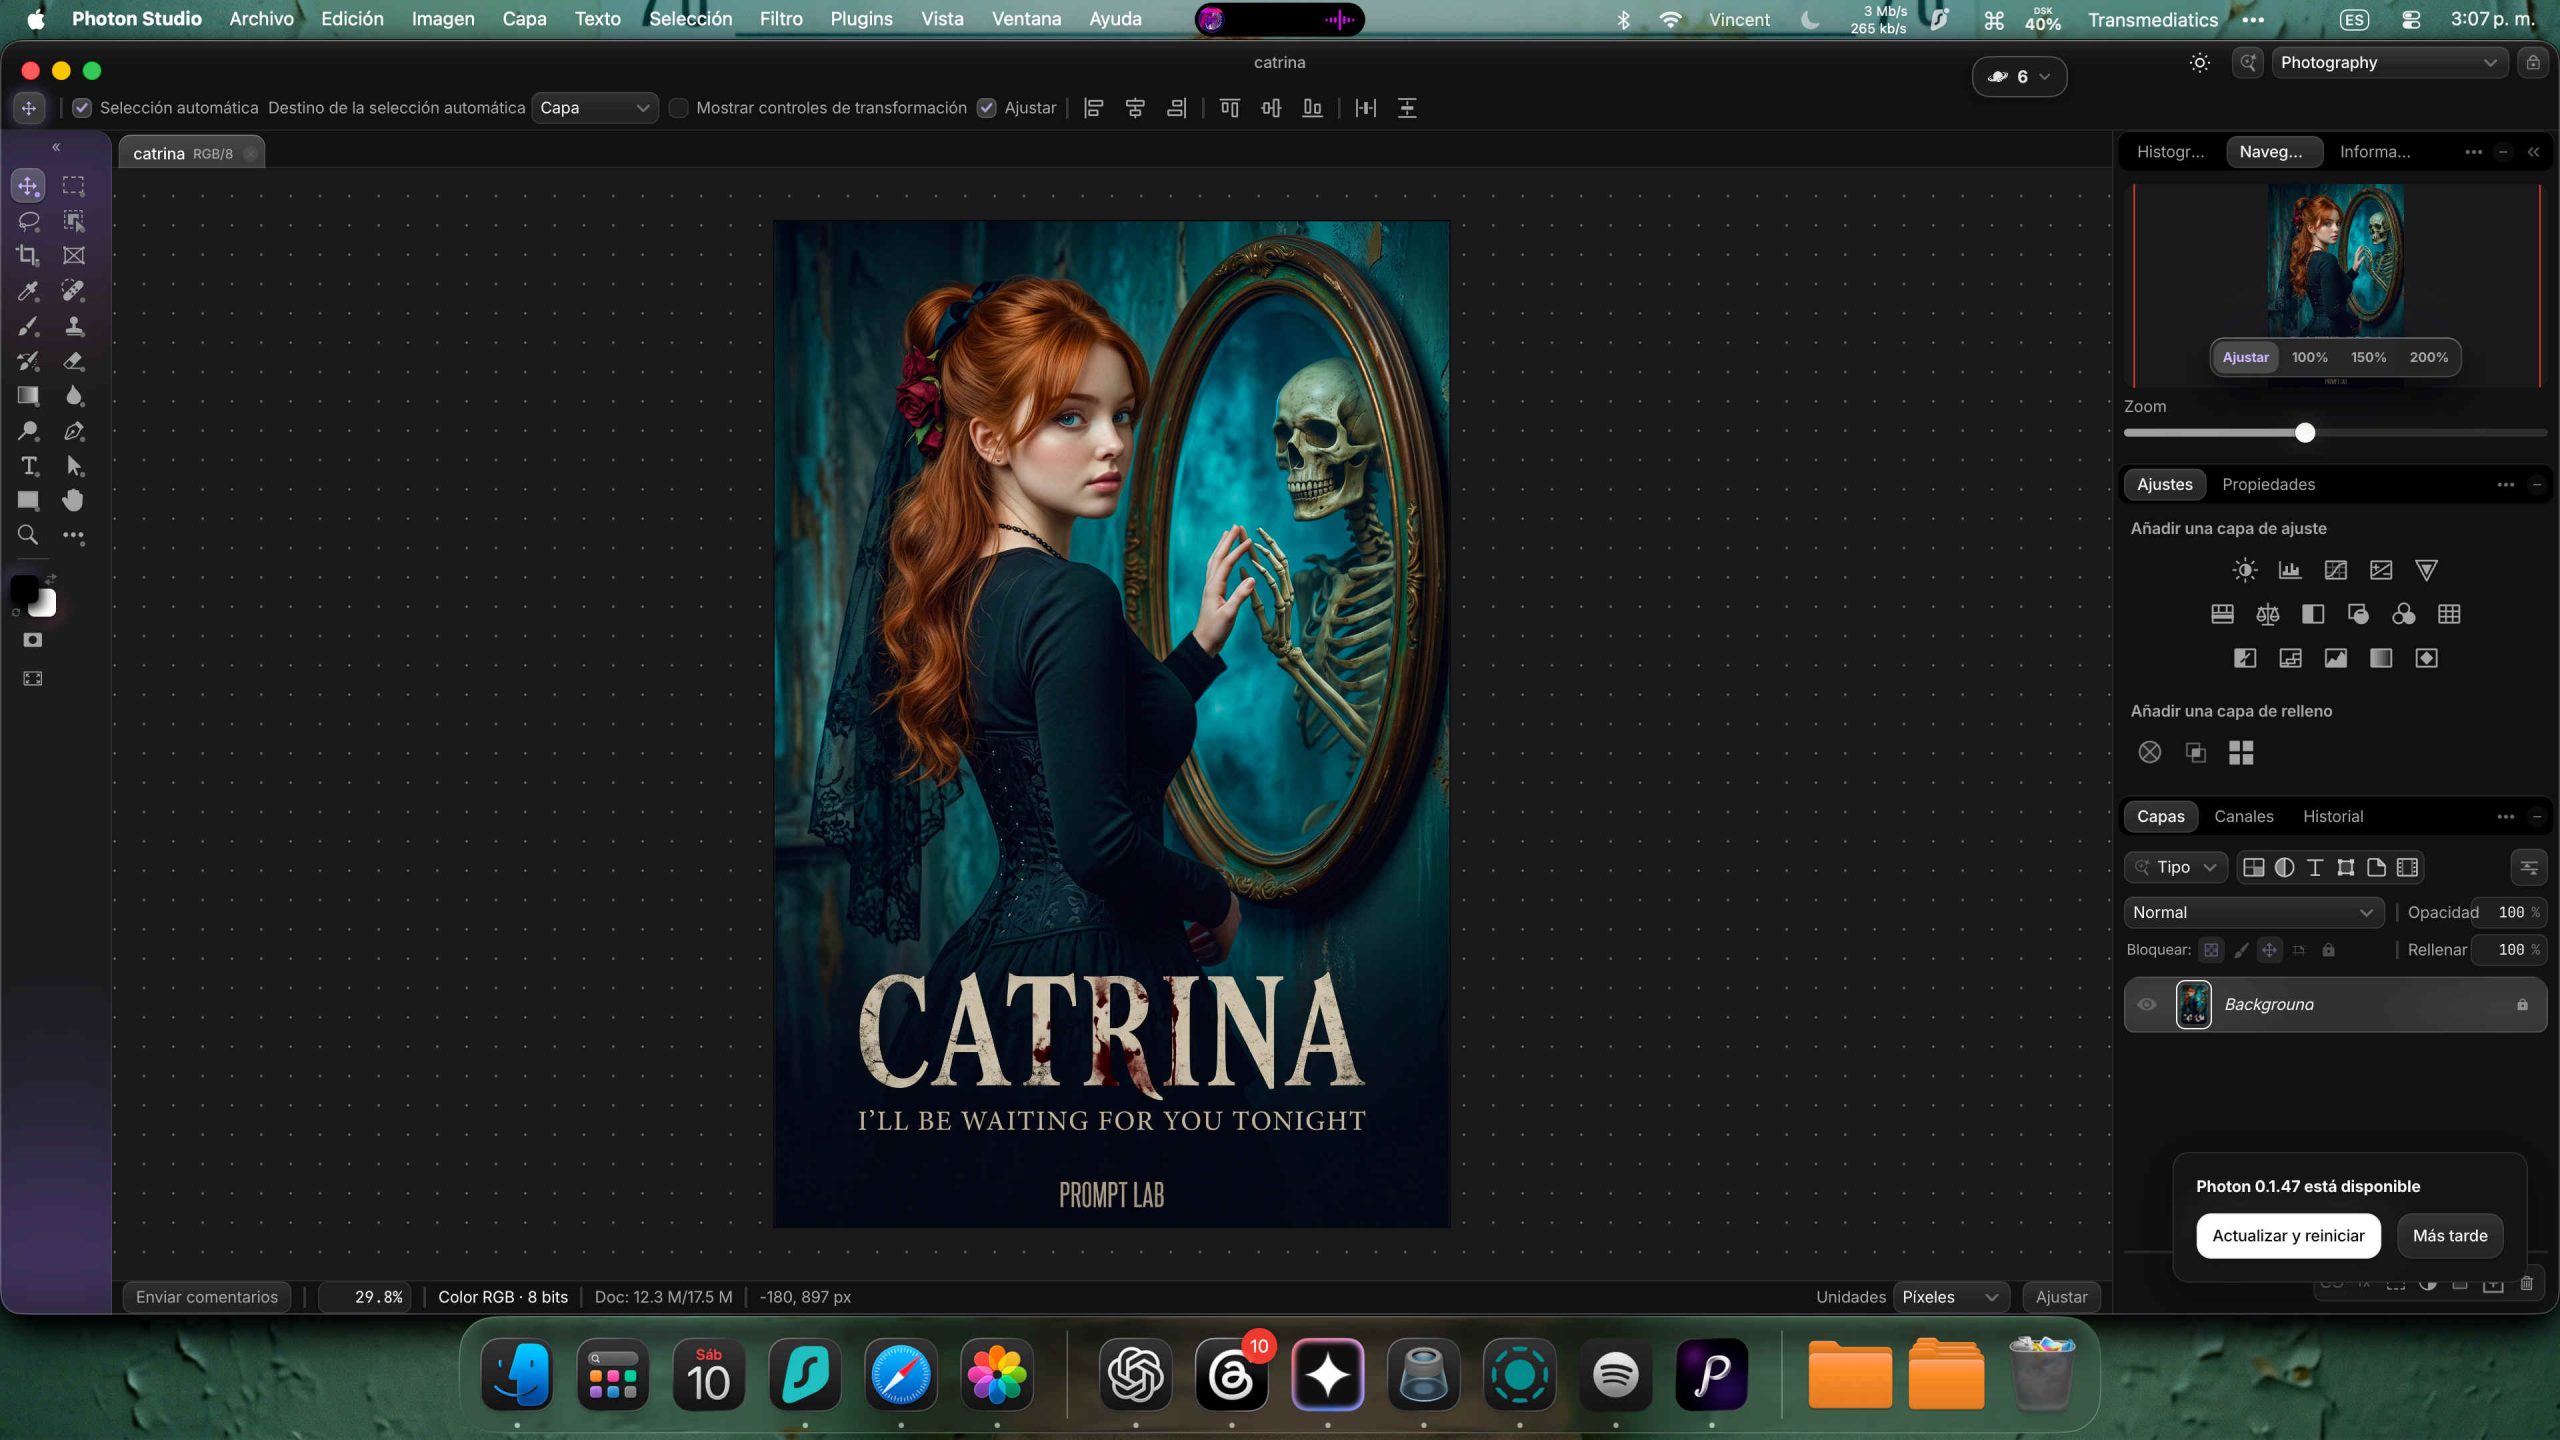
En mis últimas pruebas con Gemini PRO, trabajando en la creación de un póster cinematográfico de terror gótico, pude comprobar algo interesante: para obtener un resultado convincente no bastaba con pedir una imagen oscura, elegante y aterradora. Había que dirigir con precisión la identidad de la modelo, el vestuario, la composición, la iluminación y la intención visual.
El resultado me llevó a revisar la estructura de mis prompts y a ajustar la manera en que asigno funciones a cada referencia.
Pero ¿qué está cambiando realmente en Gemini y cómo podemos aprovechar sus capacidades?
1. La generación de imágenes evoluciona hacia una mayor precisión
Google ha incorporado a sus modelos de generación y edición de imágenes capacidades como la consistencia de personajes, las modificaciones localizadas, la combinación de referencias visuales y un mejor seguimiento de instrucciones complejas.
La familia de modelos Nano Banana, integrada en el ecosistema Gemini, está diseñada para facilitar este tipo de trabajo. Las capacidades concretas dependen del modelo utilizado. Nano Banana Pro, por ejemplo, está orientado a la producción visual profesional, la interpretación de instrucciones complejas y la generación de imágenes de alta resolución.
¿Qué significa esto para quienes trabajamos con prompts?
Que podemos plantear una dirección artística más estructurada.
En lugar de subir una fotografía y pedir que la IA la convierta en una escena de terror, podemos especificar qué elementos debe conservar, cuáles debe transformar y qué aspectos no debe modificar.
Por ejemplo:
- Una imagen define la composición y la atmósfera.
- Otra establece la identidad facial de la modelo.
- Una tercera determina el vestuario. (Pinterest).
- El prompt establece la iluminación, el encuadre, la estética cinematográfica y la jerarquía tipográfica.
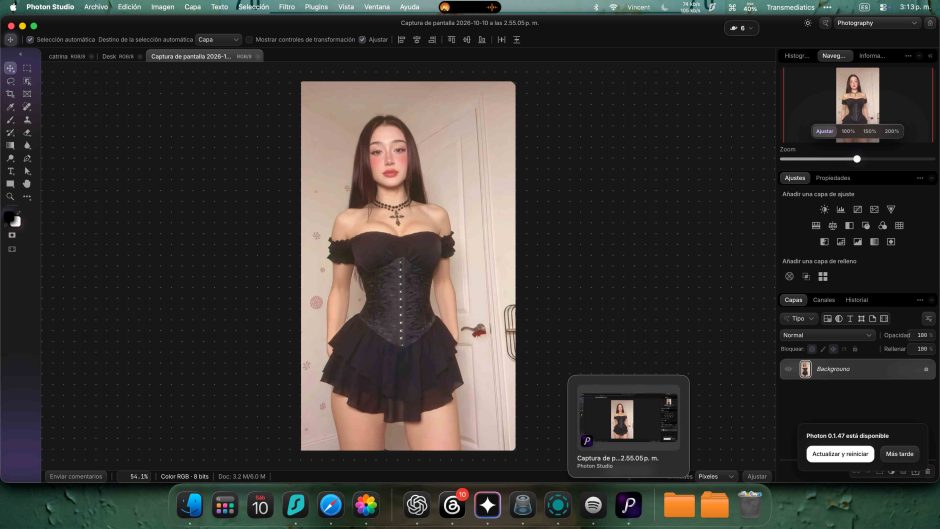
Esta separación no garantiza una reproducción perfecta, pero hace que las instrucciones sean más claras y reduce las posibilidades de que el modelo mezcle referencias que cumplen funciones diferentes.
La clave no consiste en subir más imágenes sin criterio. Consiste en explicar qué debe aprender el modelo de cada una. ☝🏻
2. El rostro, el vestuario y la escena deben tener funciones independientes
Uno de los problemas más frecuentes al generar retratos con referencias es que el modelo interpreta la imagen como un conjunto y termina mezclando características.
Podemos subir una fotografía de una modelo, una referencia de un vestido y una escena cinematográfica. Sin instrucciones precisas, el resultado podría conservar la composición, pero modificar el rostro o inventar un vestuario diferente.
Para evitarlo, conviene establecer una jerarquía explícita.
Referencia 1: composición. Define la posición del personaje, el escenario, la perspectiva, el espejo y la iluminación general.
Referencia 2: identidad. Determina el rostro que queremos conservar, incluyendo sus proporciones y características reconocibles.
Referencia 3: vestuario. Establece el diseño, la silueta, los materiales, los colores y los detalles de la ropa.
El principio es sencillo: cada referencia tiene una responsabilidad.
También debemos reconocer una limitación. Aunque los modelos actuales pueden mantener mejor la apariencia de una persona, la consistencia facial no es infalible. Por eso es importante revisar el resultado y corregirlo cuando sea necesario.
3. Bajo, Medio y Alto: ¿qué cambia realmente?
En Gemini, los niveles de razonamiento disponibles permiten ajustar cuánto esfuerzo dedica el modelo a analizar una tarea antes de responder.
La documentación de Google describe los niveles Bajo, Medio y Alto como distintas configuraciones de razonamiento para los modelos compatibles. No todos los modelos ofrecen exactamente las mismas opciones.
Es importante distinguir estos controles de la resolución, el formato o la calidad de salida de una imagen. Elegir un nivel de razonamiento superior no garantiza automáticamente una imagen más bella, una anatomía perfecta o una identidad facial más fiel.
Sin embargo, cuando la tarea implica instrucciones complejas, el razonamiento adicional puede resultar útil.
Nivel BAJO: velocidad y tareas sencillas
El nivel Bajo está orientado a tareas que no necesitan un análisis demasiado elaborado.
Puede ser apropiado para:
- Generar una imagen a partir de una descripción sencilla.
- Cambiar el color de una prenda.
- Probar una iluminación diferente.
- Realizar modificaciones pequeñas y concretas.
- Explorar rápidamente varias ideas visuales.
Por ejemplo, si tenemos un retrato y queremos cambiar el fondo por una calle lluviosa durante la noche, una instrucción directa puede ser suficiente.
No necesitamos construir una compleja jerarquía de referencias para cada modificación menor.
Cuándo utilizarlo: cuando la tarea es sencilla, las restricciones son pocas y la velocidad importa más que la planificación detallada.
Nivel MEDIO: equilibrio entre precisión y complejidad
El nivel Medio ofrece un equilibrio entre el esfuerzo de razonamiento y la rapidez de respuesta en los modelos que lo admiten.
Puede resultar útil cuando necesitamos combinar varias instrucciones sin convertir el proceso en una tarea excesivamente compleja.
Algunos ejemplos:
- Mantener la identidad de una persona mientras cambiamos el escenario.
- Combinar una referencia de composición con otra de vestuario.
- Diseñar una imagen publicitaria con una jerarquía visual definida.
- Ajustar una pose, una paleta cromática y una iluminación.
- Crear una composición con varios elementos que deben relacionarse correctamente.
Imaginemos que queremos convertir un retrato en una fotografía editorial de moda.
Necesitamos conservar el rostro, adaptar el vestuario, controlar la iluminación y evitar que el fondo distraiga de la modelo.
El nivel Medio puede ser una opción razonable para comenzar a experimentar con este tipo de instrucciones, aunque el resultado dependerá también del modelo y de la complejidad de la imagen.
Cuándo utilizarlo: cuando el proyecto exige coordinación entre varios elementos, pero no requiere una planificación especialmente profunda.
Nivel ALTO: instrucciones complejas y dirección artística detallada
El nivel Alto permite dedicar más esfuerzo al razonamiento en los modelos compatibles. Está pensado para tareas que se benefician de un análisis más profundo y de una planificación de varios pasos.
En el trabajo visual, puede resultar conveniente cuando el prompt contiene numerosas restricciones y relaciones entre referencias.
Por ejemplo, un póster cinematográfico que exige:
- Conservar exactamente la identidad de una modelo.
- Reproducir un vestuario tomado de otra fotografía.
- Respetar una composición de referencia.
- Crear un reflejo sobrenatural coherente con la posición del personaje.
- Mantener una iluminación dramática sin ocultar el rostro.
- Incorporar un título y un subtítulo con textos exactos.
- Organizar todos los elementos en un formato vertical.
Aquí no estamos solicitando simplemente una imagen bonita. Estamos definiendo un sistema visual en el que cada elemento debe cumplir una función.
Un mayor esfuerzo de razonamiento puede ayudar al modelo a gestionar las relaciones entre las instrucciones, pero no elimina todos los errores. La fidelidad del rostro, la anatomía, los detalles de la ropa y la tipografía deben verificarse igualmente.
Cuándo utilizarlo: cuando el prompt contiene múltiples referencias, restricciones estrictas, una composición compleja y requisitos específicos de acabado.
Una advertencia importante
No debemos confundir el nivel de razonamiento con un control directo sobre el estilo visual.
Bajo, Medio y Alto no significan necesariamente:
- Calidad baja, media y alta.
- Imagen de baja, media y alta resolución.
- Realismo básico, avanzado y profesional.
- Fidelidad facial garantizada en el nivel superior.
Son controles de esfuerzo de razonamiento en los modelos compatibles. La disponibilidad y el comportamiento exactos dependen del modelo seleccionado.
Además, Google documenta procesos de razonamiento específicos para determinados modelos de generación de imágenes. Por eso, no conviene asumir que todos los controles de la aplicación funcionan de la misma manera en cada modelo.
4. El verdadero avance está en aprender a dirigir las referencias
En mis pruebas con Catrina, descubrí que una parte fundamental del resultado no dependía de añadir más adjetivos, sino de definir mejor la intención.
El primer planteamiento producía una estética excesivamente envejecida. El vestido parecía demasiado holgado y la protagonista perdía la presencia que necesitaba la escena.
El problema no era que el terror gótico estuviera mal planteado. Era que las instrucciones daban demasiado peso al desgaste de la ropa y no definían suficientemente la silueta.
La solución fue corregir la dirección artística.
El vestuario debía ser entallado, elegante y sensual, con una silueta estilizada y una cintura definida. La protagonista debía resultar imponente y atractiva sin perder el carácter sobrenatural de la escena.
También se mantuvieron separadas las referencias de composición, identidad facial y vestuario.
El resultado mejoró porque las instrucciones describían con mayor claridad lo que debía permanecer y lo que podía transformarse.
Esta experiencia ilustra un principio fundamental del prompt engineering visual:
No basta con describir lo que queremos ver. También debemos especificar qué no queremos que cambie.
5. Sensualidad sin exhibición: la intención también se diseña
Una de las decisiones creativas más interesantes de Catrina fue buscar sensualidad sin recurrir a la desnudez ni a una exposición innecesaria del cuerpo.
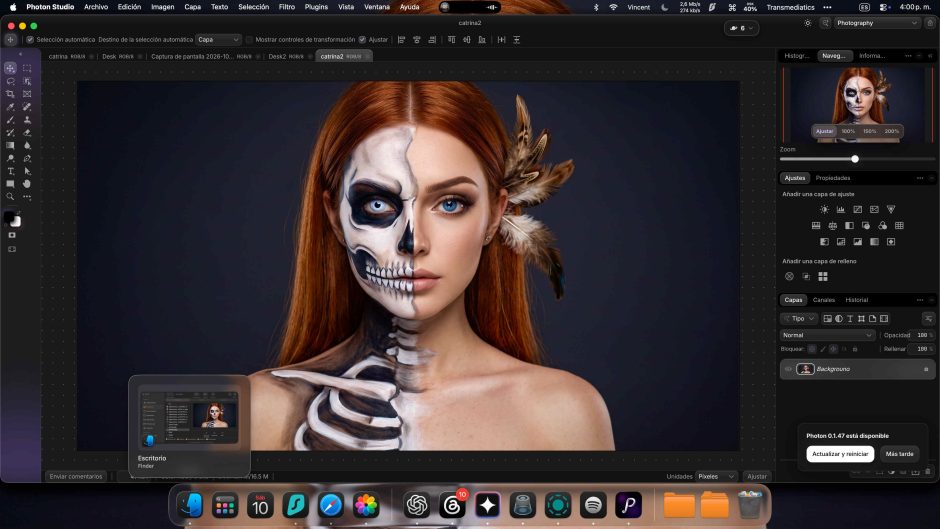
La intención era construir una protagonista estilizada, atractiva e imponente.
Para conseguirlo, la dirección del vestuario se centró en:
- Una silueta entallada.
- Una cintura definida.
- Una construcción de alta costura.
- Encaje sofisticado y materiales realistas.
- Una pose que transmitiera seguridad.
- Una expresión intensa y misteriosa.
- Una iluminación que resaltara los rasgos de la modelo sin borrar su identidad.
La sensualidad no dependía de mostrar más piel. Dependía de la relación entre la silueta, la postura, la iluminación, el vestuario y la expresión.
Este es un aspecto importante del diseño visual: la intención no surge de un único elemento, sino de cómo todos trabajan juntos.
Una imagen puede ser sensual sin resultar explícita, elegante sin ser conservadora y aterradora sin renunciar a la belleza.
6. Cómo trabajar con mayor precisión en Gemini PRO
Para quienes quieran experimentar con este enfoque, recomiendo un flujo de trabajo sencillo.
Paso 1. Define el objetivo.
Antes de escribir el prompt, determina qué debe comunicar la imagen. No te limites a enumerar objetos o características.
Paso 2. Separa las referencias.
Si necesitas controlar el rostro, la composición y el vestuario, especifica la función de cada fotografía.
Paso 3. Establece prioridades.
Indica qué elementos son innegociables y cuáles pueden adaptarse para integrarse en la escena.
Paso 4. Describe las relaciones.
No escribas únicamente que quieres una mujer, un espejo y una calavera. Explica dónde está cada elemento, cómo se relacionan y qué debe aparecer reflejado.
Paso 5. Define la intención visual.
Especifica si buscas una estética editorial, publicitaria, cinematográfica, documental o fantástica.
Paso 6. Elige el nivel de razonamiento cuando esté disponible.
Prueba Bajo para tareas sencillas, Medio para composiciones de complejidad moderada y Alto para instrucciones que requieren coordinar numerosos elementos.
Paso 7. Evalúa el resultado.
Comprueba el rostro, la anatomía, el vestuario, la composición y los textos. Si algo falla, corrige ese elemento específicamente en lugar de reconstruir todo el prompt sin necesidad.
Paso 8. Refina con intención.
Una corrección precisa suele ser más útil que añadir veinte adjetivos nuevos.
7. ¿Qué debemos esperar de Gemini en esta nueva etapa?
Las herramientas de generación visual continúan evolucionando. Google ha documentado mejoras en consistencia de personajes, edición localizada, seguimiento de instrucciones y representación de texto, aunque persisten limitaciones y el rendimiento puede variar según el modelo y la tarea.
Por eso, mi recomendación es no medir la evolución de una herramienta únicamente por la espectacularidad de una imagen aislada.
Debemos observar si responde mejor a las instrucciones, si conserva los elementos que necesitamos, si permite corregir errores concretos y si nos ofrece un control creativo más consistente.
En el trabajo profesional, esos detalles importan.
Una imagen puede impresionar a primera vista y, sin embargo, fallar en el rostro, el vestuario o la tipografía. La calidad no está solamente en lo que se ve, sino también en cuánto control tenemos sobre el resultado.
Conclusión: la IA genera, pero la dirección sigue siendo nuestra
Gemini PRO y los modelos de generación visual de Google ofrecen herramientas cada vez más capaces para combinar referencias, editar imágenes y ejecutar instrucciones complejas.
Pero ninguna herramienta sustituye la necesidad de tomar decisiones creativas.
La inteligencia artificial puede interpretar una descripción, combinar fotografías y proponer soluciones visuales. Nuestro trabajo consiste en definir el objetivo, establecer prioridades, reconocer los errores y dirigir las correcciones.
En Catrina, el cambio decisivo no fue pedir más terror. Fue comprender qué tipo de protagonista necesitaba la historia y ajustar el prompt para conseguirlo.
Esa es la diferencia entre acumular instrucciones y dirigir una imagen.
No enseño a usar IA. Enseño a pensar con ella.
Prompt Engineering · Diseño · Storytelling · Marketing
PROMPT LAB | TRANSMEDIATICS
Referencias para ampliar
- Documentación oficial de Gemini: selección de modelos y niveles de razonamiento
- Google AI: generación de imágenes con los modelos Gemini
- Google: recomendaciones para escribir prompts con Nano Banana Pro
- Google: generación y edición de imágenes en Gemini